Migracija s platforme CUDA na AMD-ovu otvorenu platformu ROCm uvelike je pojednostavnjen
Deset godina razvoja donijelo je AMD-u zreliju softversku platformu, jednostavnije pokretanje aplikacija umjetne inteligencije i alate koji olakšavaju prelazak s infrastrukture tvrtke NVIDIA.
AMD je ljetos predstavio ROCm 10, obilježavajući desetljeće razvoja svoje otvorene platforme za razvoj softvera. Istodobno je postao opće dostupan i ROCm.AI, skup alata za razvoj, izvršavanje i optimizaciju aplikacija umjetne inteligencije. Za timove s postojećim kodom za platformu CUDA ta kombinacija dodatno opravdava prelazak: uz očuvanje dosadašnjeg rada sada je jednostavniji i put do upotrebljivog AMD-ova sustava.
Mogućnost prijenosa koda postoji godinama. Časopis ADMIN Magazine još je 2019. opisao migraciju simulatora HACC, pri kojoj je 95 posto koda ostalo neizmijenjeno ili je automatski prevedeno. Do 2024. TensorWave već je razmatrao prelazak u kontekstu dostupnosti AMD-ovih akceleratora u oblaku, podrške za PyTorch i TensorFlow te gotovih softverskih paketa. Promatrani zajedno, ti izvori pokazuju kako se oko alata za prijenos koda razvilo šire okruženje za umjetnu inteligenciju.
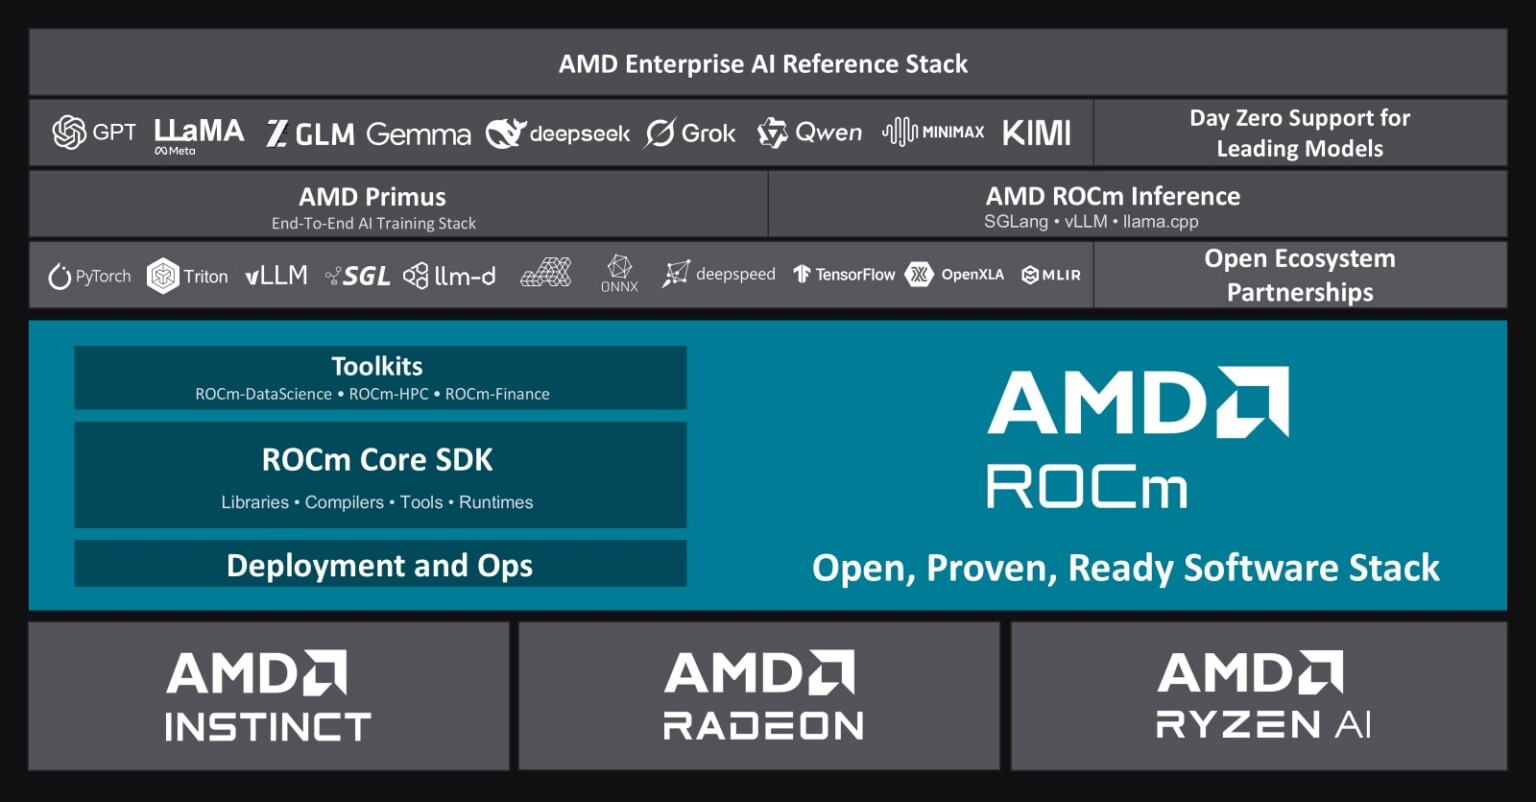
Prvi je razlog za migraciju stoga očuvanje ulaganja u softver. HIP pruža programski sloj blizak modelu CUDA, dok HIPIFY automatski prevodi mnoge pozive i programske konstrukcije. Kod se zatim kompilira za ciljni hardver. Time se otvara mogućnost održavanja zajedničke baze koda za platforme tvrtki AMD i NVIDIA, uz potrebne prilagodbe. AMD upravo taj pristup ističe u svojoj objavi na blogu o prelasku s platforme CUDA na ROCm.
Za standardne aplikacije u PyTorchu prelazak može biti još jednostavniji. Izdanje za ROCm namjerno zadržava sučelje torch.cuda, pa postojeći kod često zahtijeva tek manje izmjene, a katkad nikakve. Tim tako može nastaviti upotrebljavati poznato razvojno okruženje dok se izvršavanje prebacuje na AMD-ov GPU.
Drugi je razlog manje vremena potrebnog za uspostavu infrastrukture. ROCm 10 donosi provjerene kontejnere za vLLM i SGLang, pakete za Python i modularni Core SDK, koji omogućuje instaliranje potrebnih komponenti. AMD Primus objedinjuje pripremu i praćenje treniranja modela, dok poboljšanja komunikacijske biblioteke RCCL podržavaju rad na više akceleratora i poslužiteljskih čvorova. Praktični je cilj brže prijeći od dostupnog hardvera do produktivnog rada.
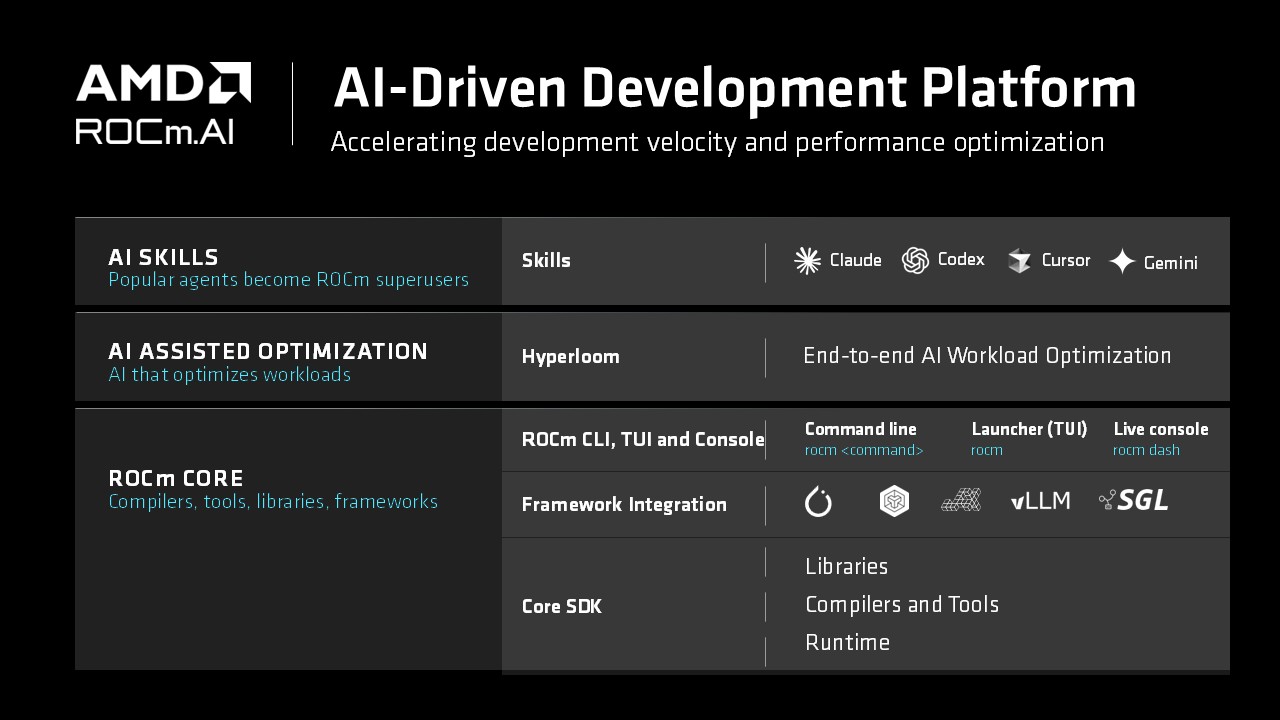
Treći je razlog lakša optimizacija postojećeg sustava. ROCm.AI putem alata AMD Skills uvodi provjerene postupke u razvojne asistente kojima se programeri već koriste. Hyperloom analizira izvršavanje aplikacije, pronalazi uska grla, primjenjuje ciljane izmjene i provjerava rezultate. Time AMD nastoji smanjiti količinu specijalističkog rada potrebnog za bolje iskorištavanje GPU-a.
Potencijal softverske optimizacije pokazuju AMD-ova interna mjerenja: na sustavu s osam akceleratora MI355X razvojno izdanje ROCm.AI, utemeljeno na optimiziranoj inačici ROCm 7.2.2, ostvarilo je prosječno 3,3 puta veću propusnost pri izvršavanju modela i 2,4 puta veću propusnost pri treniranju u odnosu na ROCm 7.0. Rezultati obuhvaćaju po tri odabrana modela; riječ je o konkretnim AMD-ovim mjerenjima, a ne o usporedbi s platformom tvrtke NVIDIA ili univerzalnom ubrzanju svake aplikacije.
Vlastiti kerneli za platformu CUDA i biblioteke za koje ne postoji zamjena u ROCm-u i dalje mogu zahtijevati dodatni rad. Za podržane aplikacije, međutim, poslovni je argument jasan: sačuvati kod, skratiti pripremu okruženja i dobiti širi izbor hardvera. Kada provjera vlastitog modela potvrdi željene performanse i troškove, činjenica da je razvoj započeo na platformi CUDA prestaje biti prepreka prelasku na AMD.