NVIDIA DGX Spark proširuje skalabilnost: Klasteri od 8 računala i do 1 TB objedinjene memorije za pokretanje modela poput GLM 5.3
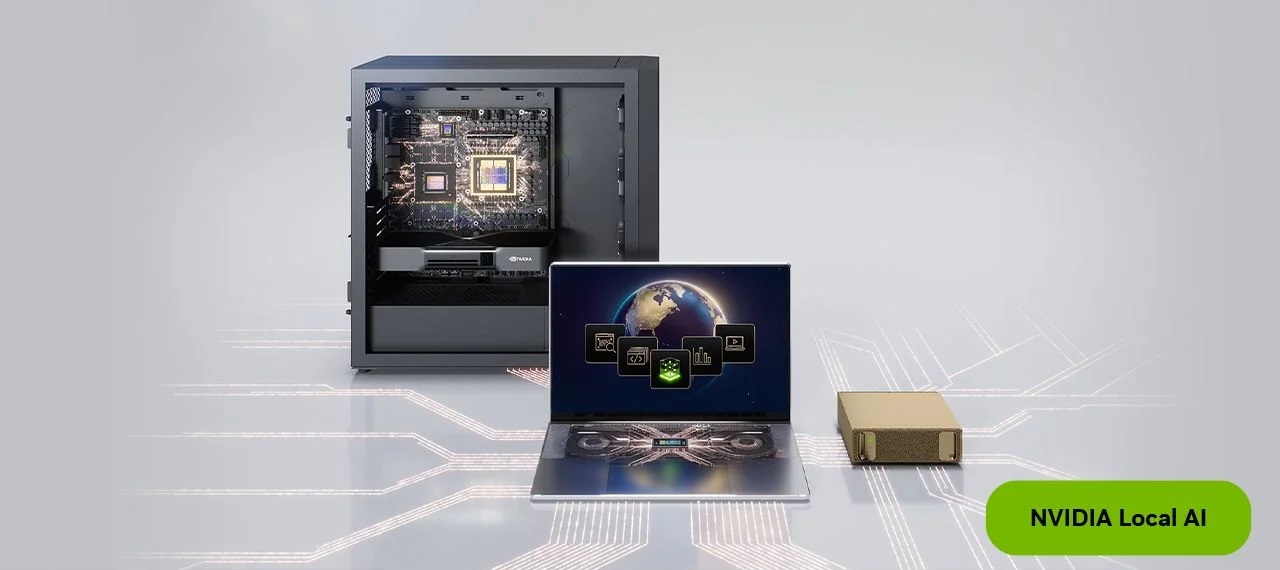
NVIDIA je službeno najavila značajno proširenje skalabilnosti svojih mini superračunala iz serija DGX Spark i RTX Spark. Nova softverska i hardverska ažuriranja omogućuju spajanje do osam domaćina (hostova) u jedinstven klaster, čime se dosadašnji limit od četiri povezana računala udvostručuje.
Ova nadogradnja donosi ogroman skok u kapacitetu dijeljene memorije. U konfiguraciji s osam sustava od kojih svaki posjeduje 128 GB objedinjene memorije, klaster postiže ukupno 1 TB dijeljene memorije. To otvara vrata lokalnom pokretanju i razvoju iznimno velikih AI modela, uključujući napredne sustave poput GLM 5.3, uz podršku za znatno dulje kontekstne prozore, rad višestrukih paralelnih agenata i distribuirani razvoj softvera.
Strategija za verziju od 64 GB i prilagođeni modeli
Kao odgovor na globalni porast troškova memorijskih modula, NVIDIA je nedavno predstavila pristupačniju verziju RTX Sparka sa 64 GB memorije. Budući da su konfiguracije od 128 GB postale financijski zahtjevne za manje razvojne timove te mala i srednja poduzeća, verzija od 64 GB nudi kompromisno rješenje uz koje klaster od osam računala i dalje postiže respektabilnih 512 GB ukupne memorije.
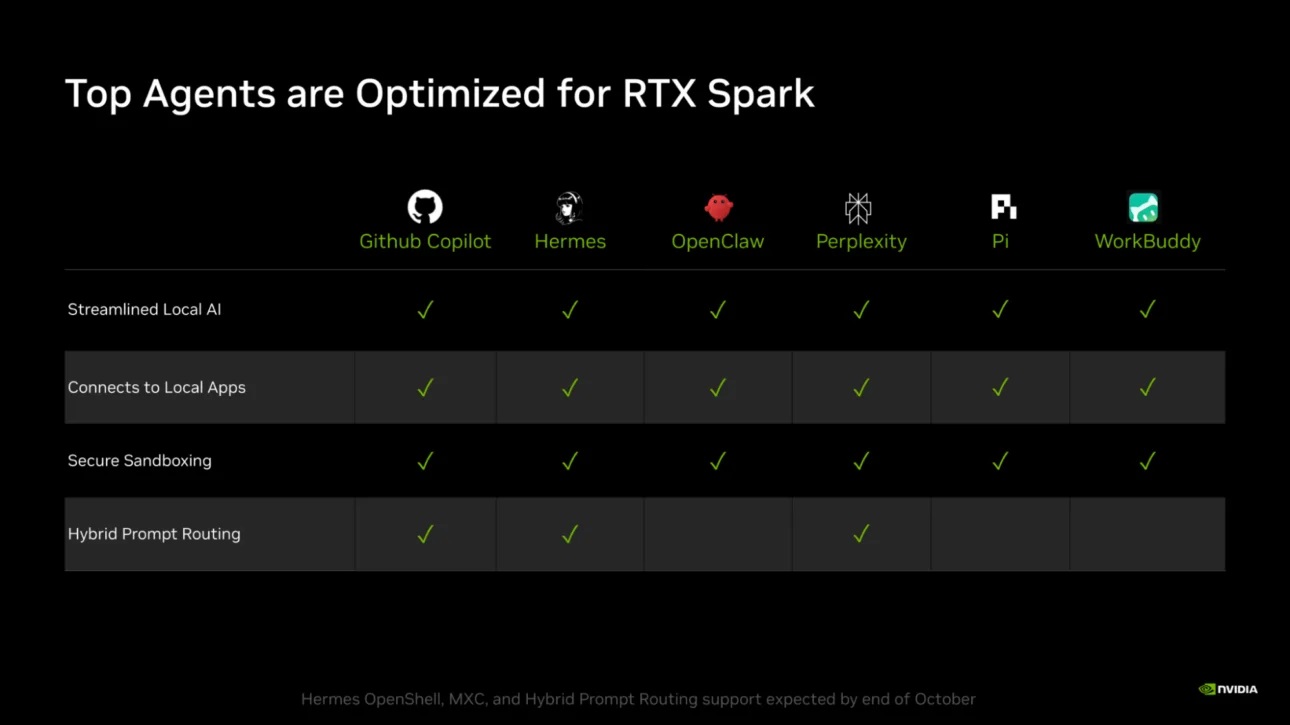
Kako bi korisnicima modela od 64 GB osigurala optimalne radne performanse, NVIDIA je preporučila i ponudila niz prilagođenih otvorenih modela:
- Nemotron 3.5 Bolt 74B (24 GB): Otvoreni model iz vlastitog razvoja, optimiziran za rad na pristupačnijem hardveru.
- Qwen 3.8 (27B) i Gemma 4 (26B-A4B): Izravno preporučeni modeli za visoke performanse unutar 64 GB okvira.
- Flint rekurzivni hibridni model: Posebno optimiziran za RTX Spark, kombinira 40 milijardi ekspertnih parametara i 2,5 milijardi aktivnih parametara, pri čemu na pojedinačnom 64 GB RTX Spark uređaju postiže brzinu zaključivanja (inference) od čak 220 tokena u sekundi.
Suradnja s zajednicom otvorenog koda i skok u performansama
NVIDIA nastavlja usko surađivati s vodećim timovima za razvoj AI modela i zajednicom otvorenog koda (uključujući vLLM, llama i CPP projekte) kako bi osigurala optimizaciju već od prvog dana izlaska novih arhitektura. Modeli poput Nemotron Bolt E4B 4B, GLM, DeepSeek, Qwen, MiniMax M3.1 i FLUX.3 Klein u potpunosti su podržani na DGX i RTX platformama.
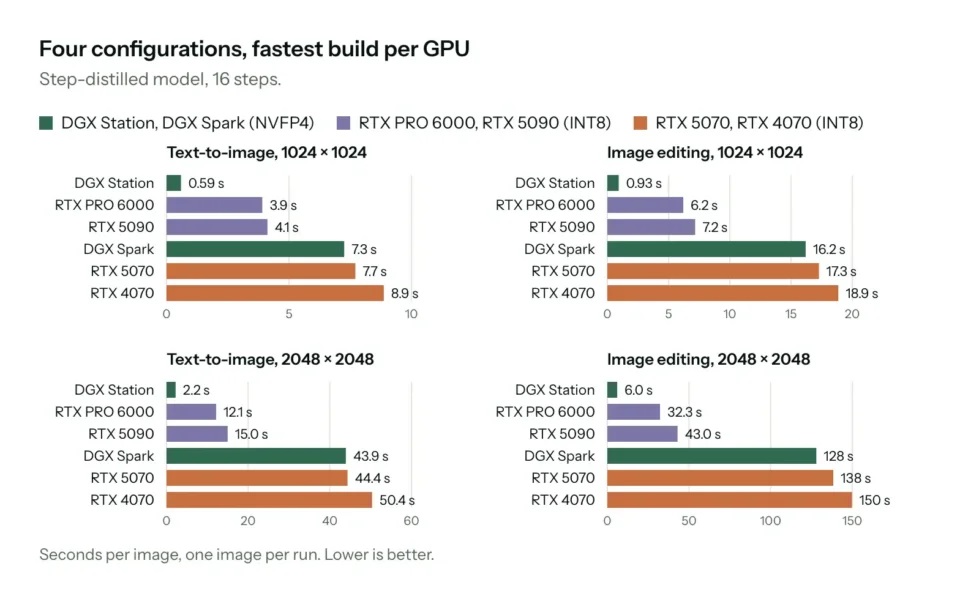
Predstavljene su i nove kvantizirane kontrolne točke modela prilagođene lokalnom hardveru, koje zadržavaju gotovo punu preciznost uz oslobađanje memorije za predmemoriranje ključeva i vrijednosti (KV cache). Zahvaljujući tim optimizacijama, model Qwen 3.8-Flash-Next-FP4-Local može se izvršavati na samo jednom RTX Spark 128GB ili RTX Pro 6000 sustavu, dok model GLM 5.3-Flash-FP4-Local zahtijeva svega dva povezana sustava.
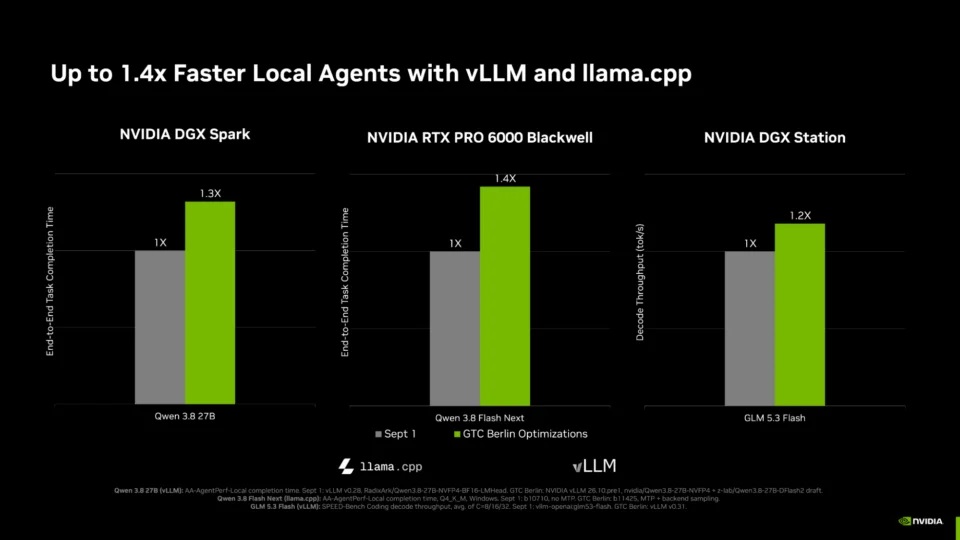
Provedene optimizacije donose i izravna ubrzanja u radu:
- DGX Spark s Qwen 3.8 (27B): Povećanje brzine zaključivanja za 30 posto.
- DGX Station s GLM 3.5 Flash: Poboljšanje performansi za 20 posto.
- RTX PRO 6000 s Qwen 3.8 Flash-Next: Impozantan skok performansi od čak 40 posto u radu s AI agentima.